Data Architecture
Understand data platform components, lake, warehouse and lakehouse patterns, storage layers and architecture decisions for scalable solutions.
Equip your technology and data teams with practical data engineering skills to design, build and optimize reliable data pipelines, data platforms and analytics-ready datasets using SQL, Python, ETL, Apache Spark and modern cloud data technologies.
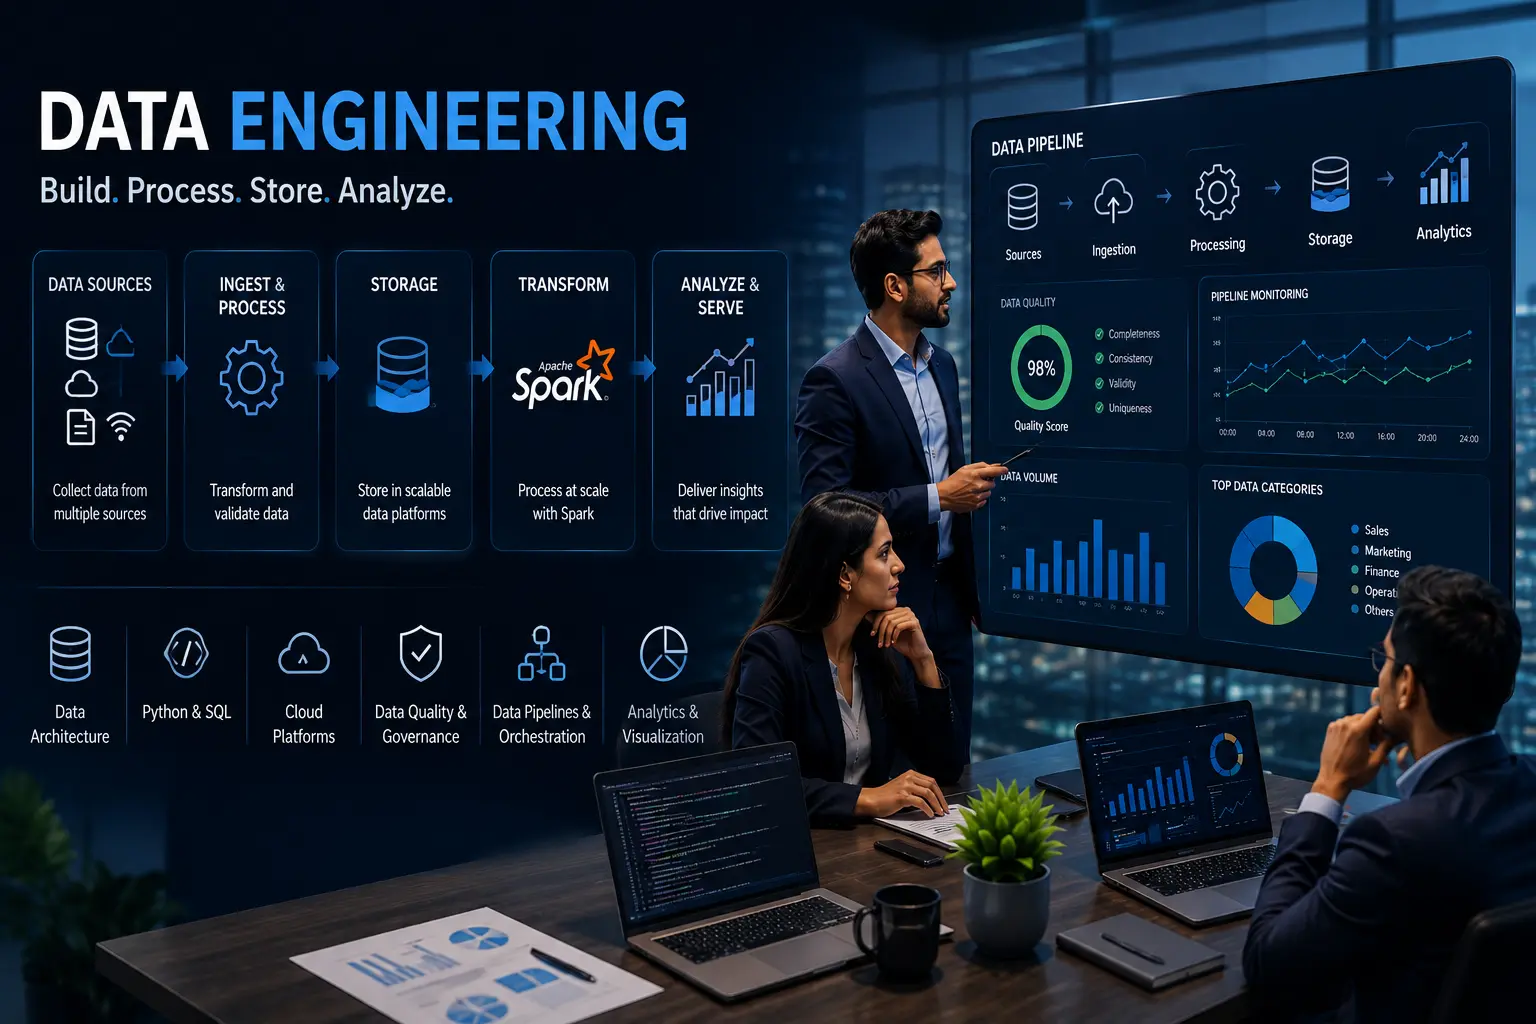
Modern data architecture
Reliable ETL and ELT workflows
Core engineering skills
Large-scale processing
Production-oriented skills
Develop practical capability across data ingestion, transformation, storage, processing, orchestration, modeling and production operations.
Understand data platform components, lake, warehouse and lakehouse patterns, storage layers and architecture decisions for scalable solutions.
Strengthen the programming and querying skills required to ingest, transform, validate and prepare data for downstream workloads.
Design robust ingestion and transformation pipelines with reusable patterns for batch processing, incremental loads and data quality.
Learn scalable processing concepts with Apache Spark, DataFrames, transformations, joins, aggregations and performance considerations.
Understand scheduling, dependency management, pipeline automation, monitoring and operational practices for production data workflows.
Build dependable pipelines with validation, error handling, performance tuning, observability and maintainable engineering practices.
Training can be customized for data engineers, ETL developers, analytics engineers, application developers and technical teams.
A structured corporate learning model built around your team's roles, technology stack, data landscape and delivery goals.
Review roles, systems, data sources, current tools and engineering challenges.
Align modules and labs with your architecture, projects and team skill gaps.
Practice ingestion, transformation, pipelines, Spark and production scenarios.
Evaluate implementation skills and identify the next engineering capability areas.
Crystalspiders provides corporate Data Engineering training for organizations that need to build stronger capabilities in data ingestion, transformation, storage, processing and delivery. The program can cover SQL, Python, ETL and ELT, data modeling, Apache Spark, orchestration, data quality, automation, cloud data engineering and production data workflows.
The training is designed around practical data engineering use cases such as extracting data from relational databases and applications, building batch pipelines, implementing incremental loads, transforming datasets, preparing analytics-ready data and improving pipeline reliability. Teams can work through engineering patterns that support maintainable, scalable and observable data workflows.
Corporate Data Engineering curriculum can be tailored for data engineers, ETL developers, analytics engineers, application developers, database professionals, architects and technical teams. Modules can be aligned with existing databases, data sources, project architecture, engineering standards and preferred data platforms while keeping the learning focused on practical implementation.
Core search and training topics covered across the program may include SQL for Data Engineering, Python for Data Engineering, ETL and ELT pipelines, data warehousing and data lakes, lakehouse concepts, Apache Spark and distributed processing, orchestration and automation, data modeling, data quality, performance optimization and cloud data platforms. This breadth helps organizations develop data engineering skills that connect source systems with reliable downstream analytics and business data workloads.
The delivery model emphasizes instructor-led learning, hands-on engineering labs, realistic data scenarios and project-oriented exercises. Programs can be structured for different experience levels and team roles, helping participants connect data engineering concepts with day-to-day development, integration, troubleshooting and production support responsibilities.
Answers to common questions about corporate Data Engineering curriculum, delivery, customization and technology coverage.
The training can cover data engineering foundations, SQL, Python, ETL and ELT, data pipelines, data modeling, Apache Spark, orchestration, data quality, performance considerations and cloud data engineering concepts.
Programs can be designed for data engineers, ETL developers, analytics engineers, application developers, database professionals, solution architects and technical teams working with data platforms and analytics workloads.
Yes. The curriculum can be aligned with your team's roles, project requirements, existing databases, data sources, engineering practices and preferred technologies, with hands-on labs built around relevant scenarios.
Yes. SQL can cover advanced querying, joins, CTEs, window functions and analytical transformations, while Python can cover data workflows, automation, file and API processing, transformation and validation patterns.
Yes. The curriculum can include source ingestion, incremental loads, ETL and ELT design, pipeline reliability, error handling, Apache Spark DataFrames and distributed processing fundamentals.
Yes. Cloud-focused modules can cover cloud storage, modern data platforms, pipeline deployment, environment management, security, monitoring and production-readiness concepts without tying the program to a single cloud provider.
Discuss your team's roles, current data stack, project requirements and preferred corporate training model with our training team.